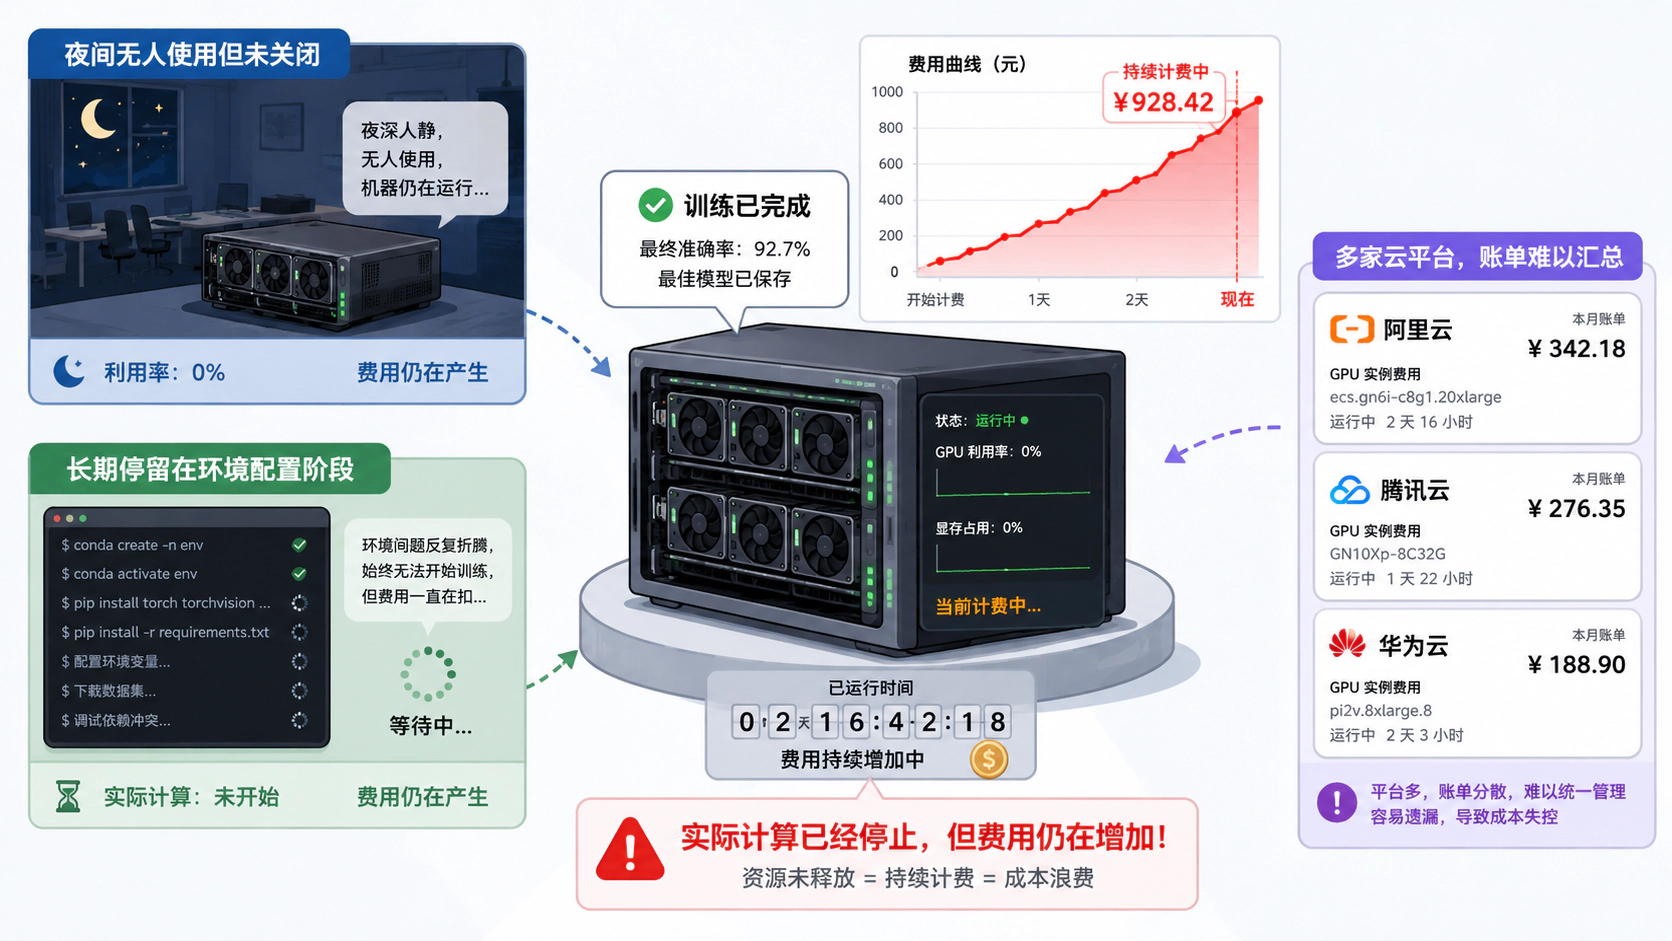
每个月底,不少 AI 团队都要经历同一幕:预算是一个数,账单是另一个数,超支 30%、50% 甚至更多。复盘时却发现实验量并没有明显增加,钱到底花到哪里去了?事实上,超支很少是因为「跑了更多实验」,绝大多数都可以追溯到三件看起来不起眼的事:忘关机、环境调试、和多云糊涂账。
一、忘关机是最大的黑洞
训练脚本跑完了,GPU 实例却还在计费——这不是偶发事故,而是很多团队的常态。晚上提交的任务半夜就跑完了,实例却一直计费到第二天上班;有人以为关掉本地终端就是关掉了云端机器;而多人共用的实例,往往谁也不敢确认此刻到底能不能关,于是谁也不关。说到底,这不是用户粗心的问题,传统云平台的设计也有责任:在多数平台上,实例是否计费只取决于你有没有手动点「释放」,和训练进程有没有跑完毫无关系。一个空跑的晚上就是几十到几百块,而这样的晚上每个月都在发生。
解法是让「跑完就停」成为平台的默认行为,而不是依赖人的自觉。Runwhere.AI 监听任务主进程,进程一退出就自动释放 GPU、计费归零,而且计费精确到秒、排队等待不计费,从机制上消灭空跑这件事本身。
二、环境调试时间被严重低估
拿到一台 GPU 实例,到真正开始训练,中间隔着一段被严重低估的时间:装 CUDA 驱动(可能失败)、创建 conda 环境、pip install(可能冲突)、同步代码,这段时间 GPU 全速计费,产出却是零。更隐蔽的是它会反复发生——换一台机器来一次,环境飘了再来一次,新人入职又来一次,日积月累下来,这笔「等机费」相当可观。
解法是环境声明式管理。用 conda environment.yml、requirements.txt 或固定镜像把环境固化下来,提交任务时由平台自动复现,既消除了手工搭建环境时的计费等待,也根治了「我这台机器上是好的」这类扯皮问题。
三、多云账单不透明,汇总时才发现问题
同时用几家云的团队,每个月还要面对多份格式各异的账单:计费单位不同、折扣规则不同,如果再混入平台转售加价就更难对齐,很多超支要等到月底汇总时才被发现,那时已经无力挽回。
解法是先把账单结构理顺。在 Runwhere.AI 的 BYOA 模式下,账务天然分成清晰的两笔——平台订阅一份账单(可开增值税专票),GPU 费用由你的云账号按官方价直接出账,没有中间加价;平台侧的订阅和超额在账务页按「明细 → 账单 → 发票」归集,随时可查、可导出。
总结
GPU 超支的解药从来不是「少跑实验」,而是把三处浪费分别堵上:自动停机堵空跑,环境复现堵调试,透明账单堵糊涂账。三件事都做完之后,预算和账单才会回到最简单的关系——花了多少,就算了多少。