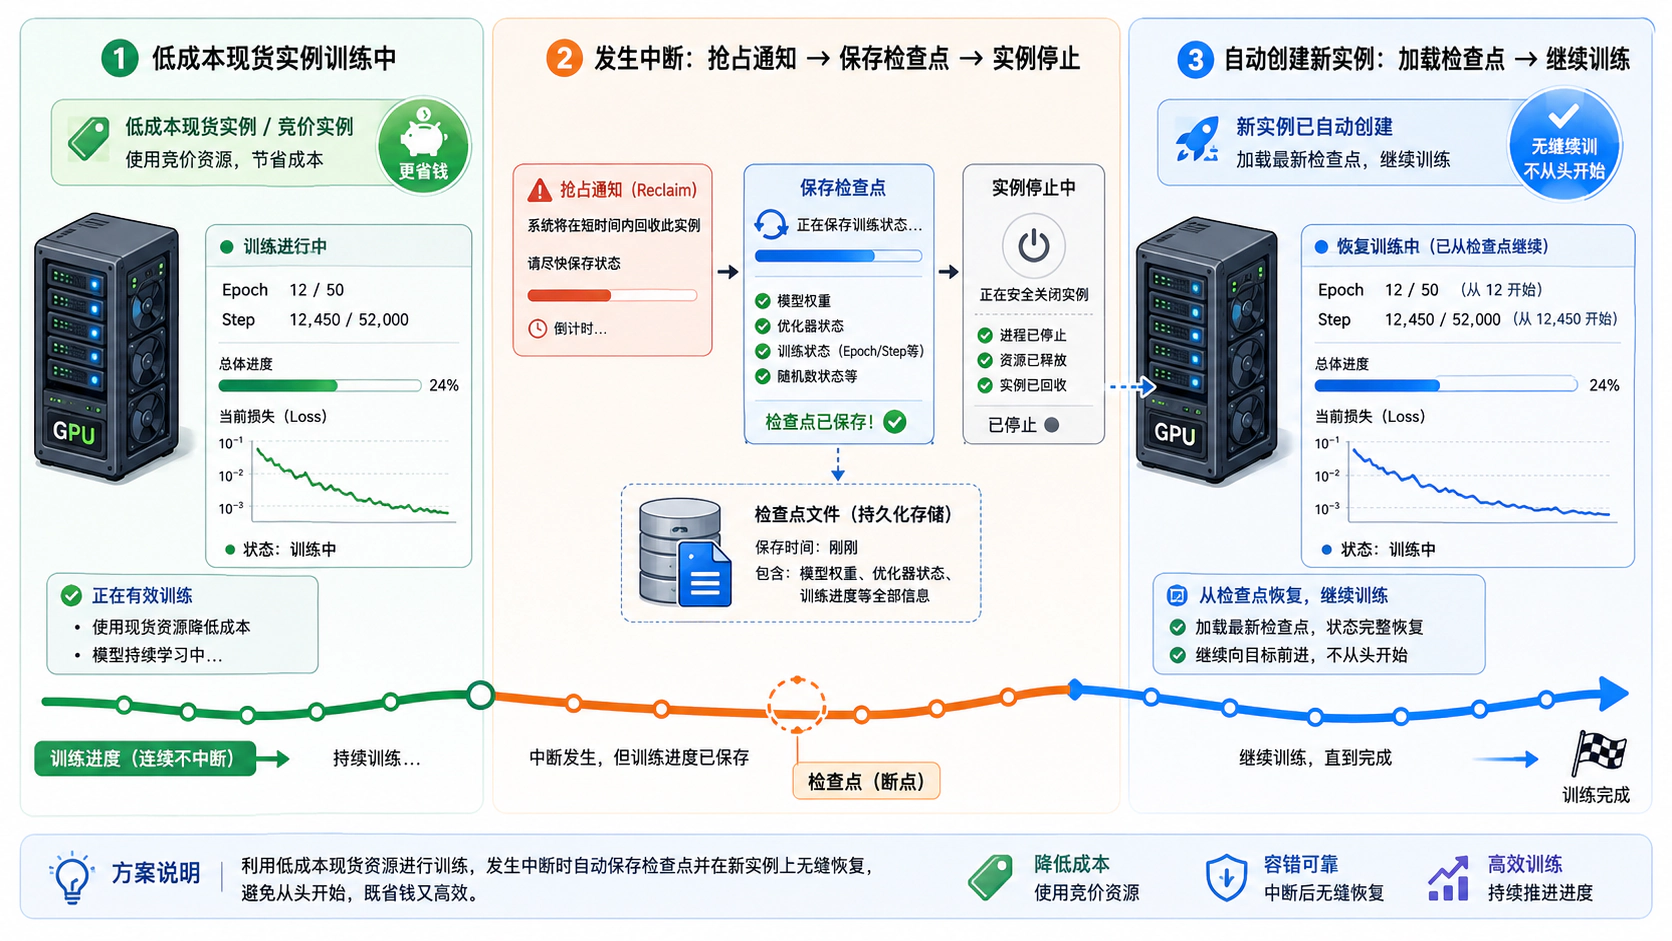
竞价实例(Spot Instance)是各大云厂商提供的低价 GPU 资源:你以远低于按量计费的价格使用闲置 GPU,代价是云厂商有权在需要时回收这台机器,折扣通常在按量价的 3-5 折区间,随供需实时波动。听起来像陷阱,但如果训练流程做好了中断容错,竞价实例能把同样的预算跑出 2-3 倍的实验量——这也是很多成熟团队的标配做法。
先看实时价格,别拍脑袋
竞价折扣不是固定值,不同云、不同区域、不同时段的差异可能很大,凭印象做决策很容易吃亏。在 Runwhere.AI 上,你可以直接在控制台「价格」页按计费模式筛选竞价机型,对比各家实时报价,或者用 CLI 拿到推荐:
runwhere price recommend -f train.yaml --top 3
选中报价后把 gpuSkuKey 写回 YAML,价格就锁定了,不会提交时才发现换了价。
核心风险:随时可能被中断
云厂商回收实例前只给一个很短的通知窗口,然后强制回收。如果训练没有 checkpoint,中断就意味着从头再来,几个小时甚至几天的计算量直接归零。所以用竞价实例的前提只有一个:你的训练必须可恢复——做到这一点,竞价就是纯粹的折扣;做不到,省下的钱迟早会以重跑的方式还回去。
安全使用竞价实例的 3 个关键
1. 高频 Checkpoint
保存频率要按时间而不是按 epoch 来定:每 10-15 分钟保存一次,中断后最多损失十几分钟的计算量;如果每个 epoch 才保存一次,一个大 epoch 跑几个小时,中断的代价就完全不可控了。
save_interval = 900  # 每 900 秒保存一次
last_save = time.time()

for step, batch in enumerate(dataloader):
    loss = train_step(model, batch)

    if time.time() - last_save > save_interval:
        save_checkpoint(model, optimizer, step)
        last_save = time.time()
在 Runwhere.AI 上,checkpoint 的存放位置在 YAML 的 storage.checkpoint 里声明,直接落在你自己云账号的存储里,实例被回收也不会丢。更完整的写法见文档站的 checkpoint 最佳实践。
2. 监听中断信号
收到回收通知后,在强制关机前抢存当前状态,能多保住一段进度。处理函数里只做一件事:保存 checkpoint,然后正常退出。
import signal
import sys

def handle_preemption(signum, frame):
    print("收到中断信号,正在保存 checkpoint...")
    save_checkpoint(model, optimizer, current_step)
    sys.exit(0)

signal.signal(signal.SIGTERM, handle_preemption)
3. 训练脚本启动时自动恢复
脚本开头先检测最新 checkpoint,存在就从断点接着跑。这样无论在新实例上重启多少次,进度都在,竞价实例的频繁回收对你的训练代码来说只是「换个地方继续」。
latest = find_latest_checkpoint(checkpoint_dir)
if latest:
    checkpoint = torch.load(latest)
    model.load_state_dict(checkpoint["model_state"])
    start_epoch = checkpoint["epoch"] + 1
什么任务适合,什么不适合
适合竞价的任务有一个共同点:可恢复、可重跑。LoRA / QLoRA 微调通常几小时内就能跑完,checkpoint 恢复快,是最典型的场景;超参搜索本来就是多次独立实验,中断一个不影响其他;数据预处理和特征工程是无状态任务,重跑成本低,也尽管丢给竞价。反过来,多节点分布式训练不适合——中断一个节点会拖累所有节点;训练时间很短的任务也不划算,省不了多少钱还平添复杂度;对可用性敏感的推理服务更要避开,中断就等于服务中断。
一句话总结:竞价实例省钱的前提是可恢复的训练流程。checkpoint 做扎实了,竞价就是纯粹的折扣;做不扎实,省下的钱迟早会以重跑的方式还回去。