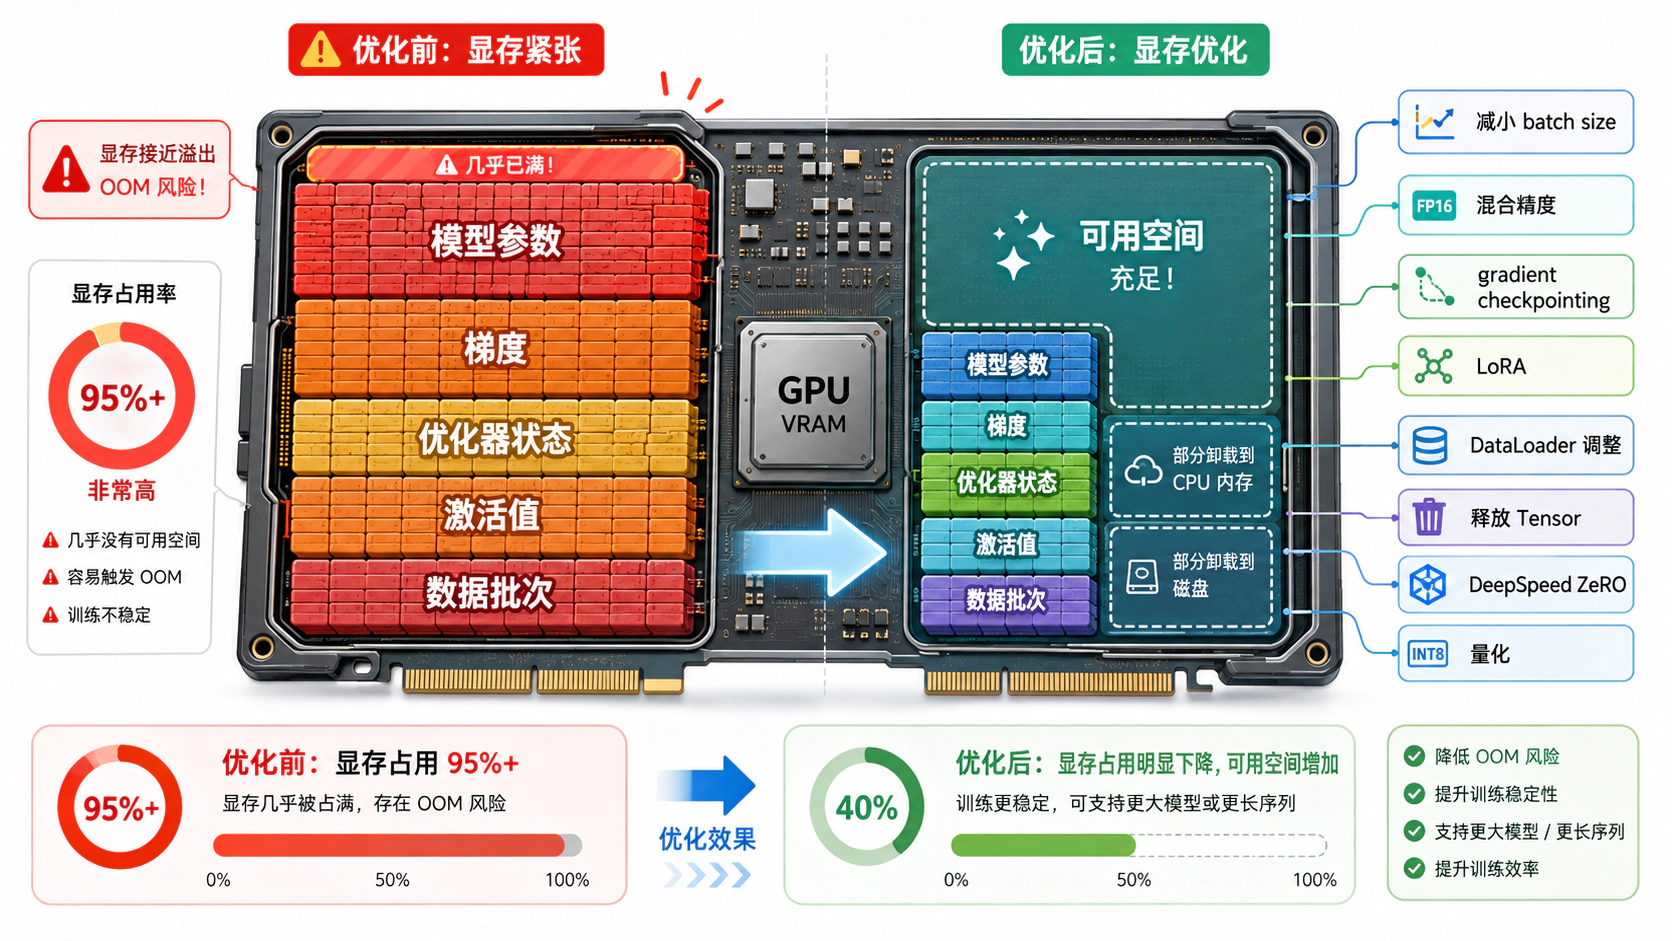
「CUDA out of memory」可能是深度学习工程师看到最多的报错。很多人的第一反应是换更大的 GPU,但在此之前,更应该先检查是不是有显存被浪费了——很多时候问题不在显卡不够大,而在显存的使用方式。以下 8 个技巧按从易到难排列,通常前 3 个就能解决大部分 OOM 问题。
1. 减小 Batch Size
最简单也最容易被忽略的方法:batch size 从 32 减到 16,显存占用几乎减半。担心影响训练效果?不一定——配合梯度累积,你可以保持等效的大 batch size,每一步的显存压力却只有原来的几分之一。
# 等效 batch_size = 32,但每步只用 8 的显存
accumulation_steps = 4
optimizer.zero_grad()

for i, batch in enumerate(dataloader):  # dataloader batch_size=8
    loss = model(batch) / accumulation_steps
    loss.backward()

    if (i + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
2. 开启混合精度训练
FP16/BF16 混合精度训练能把显存占用减少约 40%,通常还能顺便加速,是性价比最高的优化之一。A100、H100 及更新的卡都支持 BF16,优先用它。
for batch in dataloader:
    with torch.autocast(device_type="cuda", dtype=torch.bfloat16):
        loss = model(batch)
    loss.backward()
    optimizer.step()
    optimizer.zero_grad()
BF16 的动态范围与 FP32 相同,不需要损失缩放;只有用 FP16 时才需要
torch.amp.GradScaler。
3. 开启 Gradient Checkpointing
用计算换显存:前向传播时不保存中间激活值,反向传播时重新计算,显存占用可减少 60-70%,代价是训练速度慢约 20-30%。一行代码就能开启,HuggingFace Transformers 模型直接支持,适合「显存差一口气」的场景。
model.gradient_checkpointing_enable()
4. 用 LoRA 代替全参微调
全参微调 7B 模型需要存储完整的优化器状态(Adam 要额外保存 2 份参数副本),显存需求约 60GB+;LoRA 只训练极少量参数,显存需求降到 15-20GB,效果在很多场景下并不逊色。
from peft import LoraConfig, get_peft_model

config = LoraConfig(
    r=8,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
)
model = get_peft_model(model, config)
model.print_trainable_parameters()
# 输出:trainable params: 4,194,304 || all params: 6,738,415,616 || trainable%: 0.0622%
5. 调对 DataLoader 参数
DataLoader 配置不当,要么白白吃掉大量内存,要么让 GPU「饿着等数据」。num_workers 过大时,每个 worker 都会预加载数据,内存成倍增长,还可能触发系统换页、反而更慢;pin_memory=True 能加速 CPU 到 GPU 的传输、一般值得开,但内存紧张时要权衡;prefetch_factor 则保持默认值就够了,预取太多 batch 同样占内存。
dataloader = DataLoader(
    dataset,
    batch_size=8,
    num_workers=4,        # 不要设太大
    pin_memory=True,
    prefetch_factor=2,    # 默认值就够了
    persistent_workers=True,
)
6. 及时释放不需要的 Tensor
训练循环里的临时变量不及时释放,会造成显存碎片化,最典型的例子是把带计算图的 loss tensor 存进列表。只保留标量值(.item() 取出 Python 数字,计算图随之释放),显存才能在每个 step 后真正回收。
# ❌ loss tensor 持续占用显存
losses = []
for batch in dataloader:
    loss = model(batch)
    losses.append(loss)  # loss tensor 带着整个计算图

# ✅ 只保留标量值
losses = []
for batch in dataloader:
    loss = model(batch)
    losses.append(loss.item())  # .item() 取出 Python 数字,释放计算图
    loss.backward()
7. 使用 DeepSpeed ZeRO
多卡场景下,DeepSpeed ZeRO 把优化器状态、梯度、参数逐步分片到多个 GPU 上:Stage 1 只分片优化器状态,显存减少约 4 倍;Stage 2 再加分片梯度,约 8 倍;Stage 3 连参数一起分片,显存减少约 N 倍(N = GPU 数量)。即使只有一张 GPU,ZeRO-Offload 也能把优化器状态卸载到 CPU 内存,给单卡大模型训练留出空间。
8. 量化训练(QLoRA)
4-bit 量化加 LoRA 是显存优化的终极方案:7B 模型的显存需求从 60GB+ 降到 6-8GB,一张 RTX 3090 就能跑。代价是训练速度有所下降,以及量化带来的轻微精度损失,但对实验迭代来说往往完全可接受。
from transformers import BitsAndBytesConfig

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_quant_type="nf4",
)

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-2-7b",
    quantization_config=bnb_config,
)
总结
显存优化有先后次序:先试前 3 个技巧,它们零代码或一行代码,效果立竿见影;如果是微调场景,再上 LoRA,这是该场景下的主力手段;最后才考虑 DataLoader 调参、DeepSpeed、QLoRA 这些需要更多配置和理解的方案。另外,在 Runwhere.AI 上提交任务前,可以先在「价格」页按 GPU 型号对比各家云厂商的实时报价——显存需求算清楚之后,选刚好够用的机型,不多花一分冤枉钱。