Jupyter Notebook 是实验神器,但直接拿来跑生产训练,你会遇到比想象中多得多的问题。我们在平台上看到的大量训练任务失败,根因几乎都能归结为一句话:把实验代码当成了生产代码。下面这 5 个坑,几乎每一个从 Notebook 迁移过来的团队都踩过。
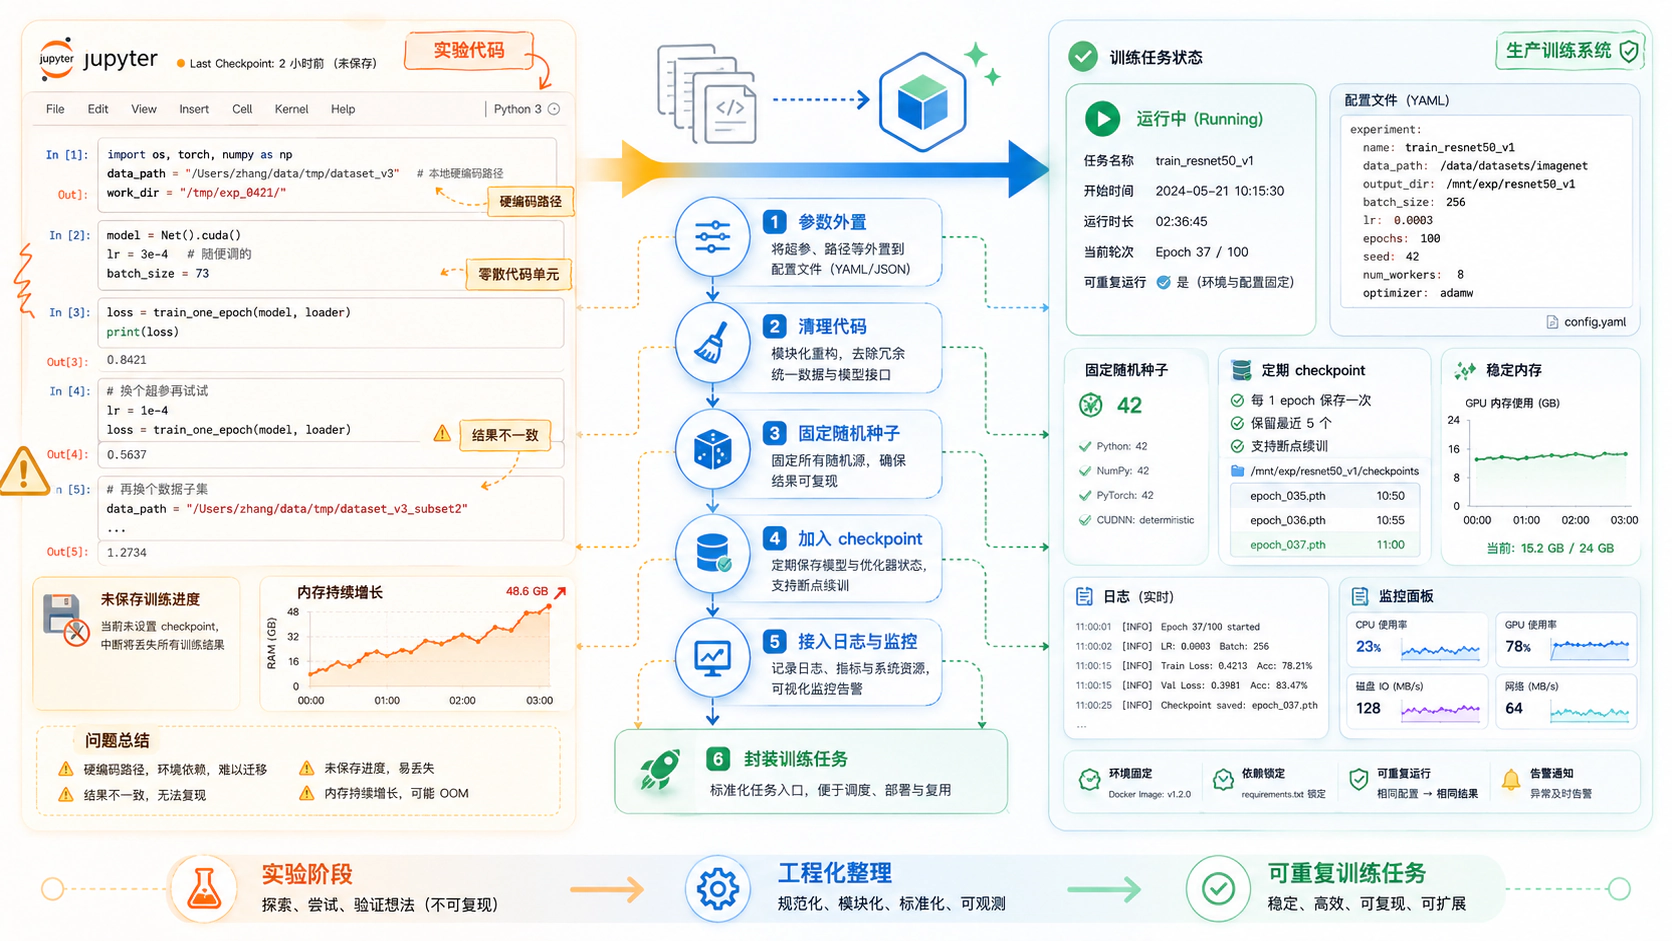
错误一:硬编码文件路径
在 Jupyter 里写 /home/user/data/train.csv 很正常——反正一直是同一台机器,路径永远有效。但换一台机器,它就是 FileNotFoundError,而生产训练恰恰是要不断换机器的。解决方案是用环境变量或配置文件管理路径,让「数据在哪」成为启动时的参数而不是代码里的常量。
import os

# ❌ 硬编码路径
data_path = "/home/user/data/train.csv"

# ✅ 环境变量
data_path = os.environ.get("DATA_PATH", "./data/train.csv")
错误二:忽略随机种子
在 Notebook 里反复运行 cell,每次结果都不一样,你却未必注意过,因为交互式实验本来就不要求可复现。到了生产训练,实验不可复现会让你浪费大量时间排查「为什么效果变差了」——是代码改坏了,还是只是随机波动?没有种子控制,这个问题无法回答。解决方案是在脚本入口统一设置随机种子。
import random
import numpy as np
import torch

def set_seed(seed=42):
    random.seed(seed)
    np.random.seed(seed)
    torch.manual_seed(seed)
    torch.cuda.manual_seed_all(seed)

set_seed()
错误三:没有 Checkpoint 机制
Notebook 里的训练通常几十分钟就跑完,挂了重跑就好,所以很少有人认真做 checkpoint。但生产训练动辄几小时甚至几天,没有 checkpoint,一次中断就意味着从头再来,而中断的原因可能是竞价实例被回收、节点故障,也可能只是你要主动更新代码。解决方案是每 N 个 epoch 保存一次 checkpoint,训练脚本启动时自动检测并从最新一份恢复。
checkpoint_dir = os.environ.get("CHECKPOINT_DIR", "./checkpoints")

# 保存
if epoch % save_every == 0:
    torch.save({
        "epoch": epoch,
        "model_state": model.state_dict(),
        "optimizer_state": optimizer.state_dict(),
        "loss": loss,
    }, f"{checkpoint_dir}/epoch_{epoch}.pt")

# 恢复
latest = find_latest_checkpoint(checkpoint_dir)
if latest:
    checkpoint = torch.load(latest)
    model.load_state_dict(checkpoint["model_state"])
    start_epoch = checkpoint["epoch"] + 1
错误四:忽略内存泄漏
Notebook 的 cell 之间共享命名空间,变量不会被回收,跑几十个 cell 后内存占用越来越高,你却可能以为这是正常的。同样的代码到了生产训练,循环跑上几十个 epoch,泄漏被放大,可能在第 50 个 epoch 撞上 OOM。解决办法有几个层面:用 del 及时释放不再需要的大 tensor,在训练循环中用 torch.cuda.empty_cache() 清理缓存,或者用 gradient_accumulation_steps 减小单步的显存占用。
错误五:没有日志和监控
Notebook 里用 print() 看结果,训练结束后输出还在页面上;生产训练跑在远程 GPU 上,没有实时日志,你根本不知道训练到哪了、loss 是否正常,等问题被发现往往已经是几小时之后。解决方案是用 Python logging 模块替代 print(可以同时写文件和标准输出),集成 TensorBoard 或 Weights & Biases 做训练监控,并让 loss、lr、GPU 利用率这些关键指标每 N 步记录一次。
import logging
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    handlers=[
        logging.FileHandler("train.log"),
        logging.StreamHandler(),
    ],
)
logger = logging.getLogger(__name__)

for epoch in range(num_epochs):
    for step, batch in enumerate(dataloader):
        loss = train_step(model, batch)
        if step % log_every == 0:
            logger.info(f"Epoch {epoch} Step {step} Loss {loss:.4f}")
总结
从 Jupyter 到生产训练,本质上是从「交互式实验」到「自动化流水线」的转变:路径要参数化、结果要可复现、中断要可恢复、内存要可控、运行要可观测。把这 5 个问题解决好,训练任务会稳定得多,排查问题的时间也会大幅减少。
Runwhere.AI 的任务提交流程天然解决了其中一部分——声明式环境让路径和依赖可预期,自动停机避免资源浪费,日志自动收集避免信息丢失——但代码层面的最佳实践,仍然要靠你自己落实。